Nextcom⁺
川濵昇先生に聞く(第6回)——生成AIのインパクト②
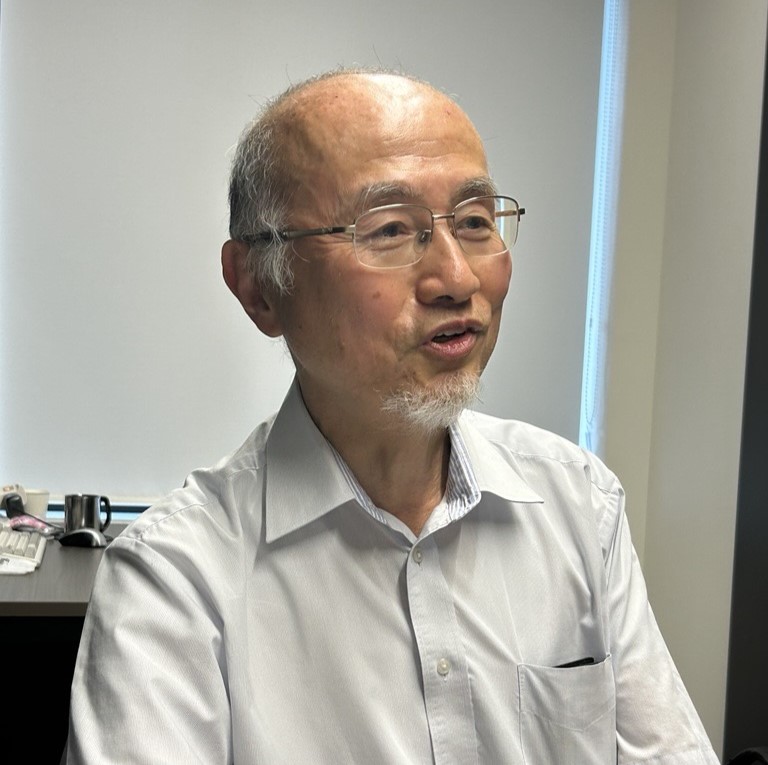
「川濵昇先生に聞く——会社法・独占禁止法・プラットフォーム規制、そして生成AIへ」と題して、Nextcom監修委員会委員長を務める追手門学院大学の川濵昇教授(経済法)へのインタビューをお届けします。最終回の今回は、前回に引き続き、生成AIのインパクトについて伺いました。
(2026年5月28日収録。聞き手:Nextcom編集長 加藤尚徳)
教育と生成AI——受験文化はすでに変わった
川濵先生:卑近な話でいくと、大学受験の勉強では、生成AIを使うのが文化になっているようです。1年ほど前に、トップエリート型の受験生が生成AIを駆使して英語の対策をやっている、というのを聞いていましたが、1年後の今は、普通の受験生が生成AIを駆使して、自分向けの問題を解かせたり、添削させたりして活用していると聞きます。これはやはり、使い方の問題というのは大きいだろうな、教育セクターの問題も変わってくるな、と感じています。
加藤:大学はどうでしょうか。中学校や高校よりは影響を受けにくいのかどうか、個人的には分からないなと思っているのですが、学生が生成AIを駆使することの影響は、今後ありそうでしょうか。
川濵先生:問題なのは、レポート試験が通用しなくなった、という話でしょうか。和文英訳・英文和訳系の問題や、要約系の問題というのは、全く使えなくなった。だから、試験のやり方の問題というのは、意識されていると思います。自分が勉強するときに、生成AIを使ってそれに教えてもらうというのは非常に有効なやり方で、それが今、生成AIの一番大きなインタラクティブな使い方ではないでしょうか。そういう使い方は、うまくやれば、自習するときの良い道具になると思います。もちろん、精度がどの程度かは、分野やレベルごとに違いはあるかもしれませんが、使ってみる価値はあるんじゃないかなとは思います。
加藤:そうですね。私が試した範囲ですと小学生の子供の勉強はほぼ完璧でした。回答を間違えた問題を読み込ませて、そこから類似の問題をランダムに出力させる、というようなことができます。おそらくサンプルが多いのと、元々の学習に使われているデータの精度にブレがない——漢字の書き方を間違えたものを学習する機会がない——からだと思います。多分、高校くらいの学習まではそれでいけると思うのですが、大学に入って、例えば法学部で学ぶようなことは、まだそれほどきちんと学習できていないのではないかと。
川濵先生:法学では、学習データをきちんと与えることの難しさがあるのかと思います。海外で、法律系のデータベースに人工知能を載せているところは、囲い込んだ文献を読ませてやっているけれども、日本では、重要なテキストが網羅的に利用可能な形では存在していません。二次文献も含めて基本的な文献を読み込んだ上でないと、良い処理はできないですよね。そういった点では、まだ精度が高くないかもしれませんね。判例なら読ませて、消化させることはできますけれども。もちろん、これも時間の問題かも知れませんが。
加藤:判例の要約まではできると思います。ただ、社会科学、特に経済学の先生の中には、「同じタイプの判例を100件集めてくれば、そこで課される罰金の平均値が出て、それが、裁判所が課す罰金の額だ」というふうに考える方がいらっしゃるんです。でも、それは違う、というのは法学者には直感的に分かっています。判例を横串で並べて意味のある部分もあれば、そうではない部分もある。体系化はできるかできないかで言えばできるけれども、判例を100個並べたからできるわけではない。その差分をAIが埋めてくるようになると、おそらく脅威なのですが、今の段階では埋めてきていないのではないか、というのが私の直感です。
川濵先生:まさに、判例の差分をどう読むか、というのは「よく読むと、ここは違うんじゃないか」という文章があって、そこを読み取れるか読み取れないかというところに次の発展がある。だから、どこまでできるかというのは、難しいとは思うんですよね。大量の文献を読み込ませた上で、「こんなとき、どんな結論を出すのが正しいか」という設問ではなく、「このようなデータを基礎に、今、私はこの状況をこう考えている。だとしたら、私の論拠を説得的にするようなものを出せますか」ということになる。それで、人間が書くもの以上に、裁判官に対して説得力のある文章が出せるかどうかが、まず最初のステップだと考えています。
「法学的チューリングテスト」——裁判官を説得できるか
川濵先生:一つ言えることは、普通の一審の場合だったら、事実認定との絡みのところもあるから、準備書面の良し悪しというのはなかなか確定が難しい。けれども、上訴趣意書・理由書を書くときというのは、基本的に、出てきた原判決に対して、法的な論点に基づいて説得的な論拠を提出する文書を作ることがポイントになってきます。そのときに、人間が作っているものよりうまく作れるか、作れないか。それが第一のハードル。これが要するに「法学的チューリングテスト」の1つだと思います。
加藤:なるほど、面白いですね。
川濵先生:実は、この今のアイデアは、最近思いついたものではないんです。第五世代も含めた、前のAIブームで、「人工知能と法律論」が議論されたときに——あれは裁判官をAIが代替できるかを軸に考えているけれども、裁判官をやったとして、その結論の良し悪しを誰が判断できるんだ、ということになります。普通に考えたら、裁判レベルでチューリングテストをやるときというのは、裁判官を相手に法的議論をする能力ということになりそうです。事実認定の問題がどうしても関わるので、評価が難しいところもありますが、木南敦先生(京都大学名誉教授)とこの話をしたときに、法的議論が重要なものとなる上訴趣意書・理由書の作成を比較して、AIの方が、うまく説得的な議論ができるようなら、人間と同等と言って良いことになりそうだということになりました。もちろん、これは大雑把な話で事実問題と法律問題がそれほど綺麗に分離できるわけではありませんが、それが法律に関するチューリングテストの1つじゃないか、と思います。余談なんですが、20世紀が終わった頃に、機械学習系の性能が今後上がってくるんじゃないか、ということを何となく予感していて、学部の授業で、「中途半端な法律の勉強をやっていると、機械に負けてしまうよ」と言っていたんです。そのときのイメージがそれだったんですね。AIもまだ一番良い弁護士には勝てないだろうと思っていますが、予備作業ではAIで十分と言うことになるかもしれません。
加藤:おっしゃる通りですね。
川濵先生:要するに、AIの性能を「裁判官の代わりが務まるか」で測るというのは一番愚の骨頂で、その裁判官としてのAIの良し悪しを誰が判断するんだ、と思うんですよね。そうではなくて、裁判官が判断するときに、良い法律論を作れるのは人間とAIのどちらか、ということで見ていくようになる。
加藤:確かに、裁判官が、人間が作った法律論の方を採用しなければならないわけでもないですよね。
川濵先生: ところで、著名な物理学者の方が、現時点では、院生レベルの力を持っており、基本的に「私がそのAIと対話して、『こいつはよくできるな』と思う程度になったら、チューリングテストをクリアしたことになる」という趣旨のお話をされていたと聞いたことがあります。このことを踏まえると、裁判官を説得できるかどうか、あるいは一流の法律家の対等の議論相手になることが、試金石のように思います。後者の方はすでに射程に入っているように思います。
加藤: 先生、本日はあっという間に時間が過ぎてしまいました。ぜひまた、続きのお話を伺わせてください。
(了)

川濵 昇(かわはま のぼる)
1981年 京都大学法学部卒業
1986年 同法学研究科退学、同助手
1988年 京都大学法学部助教授
1995年 京都大学大学院法学研究科教授
2023年 京都大学名誉教授
2023年 追手門学院大学法学部教授
<主な学会活動>
日本経済法学会理事(1999年から、2017年から2023年まで理事長)
日本国際経済法学会理事(2012年から)
日本消費者法学会理事(2019年から)等
<主な社会活動>
経済産業研究所ファカルティフェロー(2006年から)
総務省情報通信行政・郵政行政審議会会員(2013年から2023年まで、2021年から2023年まで会長)
公正取引委員会独占禁止懇話会会員(2010年から2015年まで)等